Le développement agentique : le principe
Sommaire
Vous avez sans doute déjà posé une question de code à ChatGPT, au Chat de Mistral ou à Claude, puis recopié la réponse dans votre éditeur. Depuis 2025, une autre façon de faire s'est installée chez les développeurs : l'agent de code. Vous ne lui demandez plus un bout de code, vous lui confiez une tâche (« ajoute les codes promo au panier, avec les tests »), et c'est lui qui ouvre les fichiers, les modifie, lance les tests et recommence jusqu'à ce que ce soit fini.
Cette série de trois TP fait le tour du sujet :
- le principe (ce TP) : ce qu'est un agent, de quoi il est fait, et ce qui circule réellement entre lui et le modèle ;
- l'utilisation : installer un agent, le brancher sur un modèle gratuit, et le faire travailler sur un vrai petit projet avec une méthode ;
- les limites : tout ce qui peut mal tourner, et ce que l'on attend de vous en tant que développeur.
Pas d'installation dans ce TP : on démonte la machine pour comprendre comment elle marche. Ça vous servira à chaque fois qu'un agent fera quelque chose de surprenant (et ça arrivera).
Merci à AMD University
Les modèles que nous utilisons dans cette série sont en partie mis gratuitement à disposition des étudiants par AMD, dans le cadre de son programme universitaire. Un grand merci à AMD University pour sa contribution à ce cours.
Prérequis
- Savoir ouvrir un terminal et y lancer une commande.
- Les bases de Git (
git status,git diff,git commit), vues dans l'initiation à Git. - Avoir déjà utilisé un assistant IA en mode « chat ».
- Pour la partie pratique (facultative mais conseillée) :
curletjq(ils sont déjà dans la dev-box), et l'adresse et la clé du proxy de la classe, fournies par votre enseignant.
Objectifs
À la fin de ce TP vous saurez :
- expliquer ce qu'est un agent de code : un modèle de langage dans une boucle ;
- faire la différence entre l'autocomplétion, un chat et un agent ;
- nommer les briques d'un agent : le modèle, le contexte et sa fenêtre, les outils, les permissions, les fichiers d'instructions comme
AGENTS.md; - lire une requête et une réponse de l'API d'un modèle, et reconnaître un appel d'outil ;
- citer les trois API que vous croiserez (OpenAI Chat Completions, Anthropic Messages, OpenAI Responses) ;
- estimer ce que coûte une tâche confiée à un agent, en tokens et en euros.
Un agent, c'est quoi ?
Un modèle de langage (un LLM : GPT, Claude, Mistral, Qwen, Nemotron…) ne sait faire qu'une chose : on lui donne du texte, il produit la suite. Il ne lit pas vos fichiers, il ne lance aucune commande, il n'a aucune mémoire entre deux appels.
Un agent de code, c'est un programme (OpenCode, Claude Code, Codex, pi…) qui place ce modèle dans une boucle :

- L'agent envoie au modèle tout le contexte : ses propres consignes, votre demande, la liste des outils disponibles et tout ce qui s'est passé jusque-là.
- Le modèle décide : soit il répond, soit il demande d'appeler un outil (« lis le fichier
src/panier.js»). - L'agent exécute l'outil, sur votre machine : lire un fichier, en modifier un, lancer
npm test… - Il lit le résultat, l'ajoute au contexte, et on repart au point 1.
La boucle s'arrête quand le modèle répond sans demander d'outil. Pour une petite tâche, elle tourne quelques fois ; pour une grosse, des dizaines de fois.
Question :
- Le modèle « sait-il » qu'il a modifié un fichier au tour précédent ? Comment ?
Réponse
Le modèle lui-même ne se souvient de rien : chaque appel repart de zéro. S'il « sait » qu'il a modifié un fichier, c'est uniquement parce que l'agent lui renvoie tout l'historique à chaque tour : sa demande de modification, et le résultat de l'outil (« fichier modifié »). Toute la mémoire de l'agent est dans ce texte renvoyé à chaque fois. Retenez-le, c'est la clé de la partie sur les tokens.
Autocomplétion, chat ou agent ?
Les trois utilisent les mêmes modèles. Ce qui change, c'est qui agit et ce que le modèle voit :

Avec un chat, vous êtes la boucle : vous copiez le code, vous le lancez, vous revenez avec le message d'erreur. Avec un agent, c'est le programme qui fait ces allers-retours à votre place. Il va beaucoup plus vite… et vous voyez beaucoup moins ce qui se passe. D'où l'importance de comprendre la mécanique.
Question :
- Vous demandez à un chat : « mon test
formatPriceéchoue, pourquoi ? ». Il ne peut répondre qu'à partir de ce que vous lui avez collé. Que ferait un agent avec la même phrase ?
Réponse
Il irait chercher lui-même ce qui lui manque : lire le fichier de test, lire src/panier.js, lancer npm test pour voir l'erreur exacte, puis proposer (ou faire) la correction et relancer les tests pour vérifier. Plusieurs tours de boucle, sans que vous ayez rien copié.
Les briques d'un agent
Le modèle
C'est le « cerveau » : il lit le contexte et produit la suite. Il tourne rarement sur votre machine (il faut une très grosse carte graphique), mais chez un fournisseur : OpenAI, Anthropic, Mistral, NVIDIA, AMD, ou le serveur de votre établissement. L'agent lui parle par une API HTTP, que nous verrons plus bas.
Un même agent peut utiliser des modèles très différents. Un modèle plus gros fait en général moins d'erreurs, mais coûte plus cher et répond plus lentement.
Le contexte et la fenêtre de contexte
Le contexte, c'est tout le texte envoyé au modèle à un tour donné. Le modèle ne peut en lire qu'une quantité limitée : c'est sa fenêtre de contexte, mesurée en tokens (de 32 000 à plus d'un million selon les modèles).
Chaque fichier lu, chaque sortie de commande, chaque réponse s'ajoute au contexte. Une longue session finit donc par remplir la fenêtre : l'agent doit alors compacter son contexte, nous le verrons un peu plus bas.
Les outils
Un outil, c'est une fonction que l'agent sait exécuter et qu'il décrit au modèle : un nom, une phrase d'explication, et les paramètres attendus (au format JSON Schema). Voici, un peu raccourcie, la définition de l'outil read qu'OpenCode envoie au modèle :
{
  "type": "function",
  "function": {
    "name": "read",
    "description": "Read the contents of a file or directory. [...]",
    "parameters": {
      "type": "object",
      "properties": {
        "path": { "type": "string", "description": "File or directory to read" },
        "offset": { "type": "integer", "minimum": 0 }
      }
    }
  }
}OpenCode en déclare une douzaine : read, edit, write, glob, grep, shell, webfetch, websearch… Le modèle n'exécute jamais rien lui-même : il demande un appel (« read avec path = src/panier.js ») et c'est l'agent qui l'exécute.
Les permissions
Puisque c'est l'agent qui exécute, c'est lui qui décide de ce qui est autorisé : lire oui, modifier sur demande, git push jamais, etc. Ce sont les permissions. Chaque agent a les siennes, avec des valeurs par défaut plus ou moins prudentes.
Lisez les réglages par défaut
Dans OpenCode, la règle de base est « tout est autorisé », sauf la lecture des fichiers .env qui demande votre accord (documentation des permissions). Concrètement, un agent OpenCode non configuré peut lancer rm -rf sur un dossier de votre projet sans vous demander votre avis. Nous l'avons vérifié, et nous verrons dans le TP sur les limites comment le restreindre.
Les fichiers d'instructions : AGENTS.md
Le modèle ne connaît pas votre projet. Pour lui donner les règles de la maison (comment lancer les tests, les conventions de nommage, ce qu'il ne faut pas toucher), on écrit un fichier AGENTS.md à la racine du dépôt. C'est un format ouvert, reconnu par la plupart des agents (Claude Code lit plutôt CLAUDE.md ; OpenCode lit AGENTS.md, et CLAUDE.md à défaut).
L'agent recopie ce fichier au début du contexte, à chaque tour. Voici ce qu'OpenCode a réellement envoyé au modèle avec un AGENTS.md de deux lignes dans le projet (fin du message « system ») :
Instructions from: /root/bts-panier/AGENTS.md
# Boutique BTS

- Tous les montants sont des entiers en centimes.
- Lancez npm test après chaque modification.Questions :
- Pourquoi est-il préférable d'écrire une règle dans
AGENTS.mdplutôt que de la répéter dans chaque demande ? - Que risque-t-on avec un
AGENTS.mdde 500 lignes ?
Réponse
- La règle est appliquée à chaque session, par chaque membre de l'équipe, sans que personne ait à y penser. Et elle est versionnée avec le code : elle évolue avec le projet.
- Il est renvoyé à chaque tour : 500 lignes, ce sont des milliers de tokens payés à chaque appel, et autant de place en moins dans la fenêtre de contexte. Et plus il y a de consignes, plus le modèle risque d'en oublier une. Un bon
AGENTS.mdest court et ne dit que ce que le modèle ne peut pas deviner en lisant le code.
Ce qui circule entre l'agent et le modèle
Ouvrons le capot. Chaque tour de boucle est une requête HTTP vers l'API du fournisseur.
Une requête, une réponse
Le format le plus répandu est celui d'OpenAI, Chat Completions (POST /v1/chat/completions). La requête contient le modèle, la liste des messages (avec leur rôle : system, user, assistant, tool) et la liste des outils :
{
  "model": "nvidia/nemotron-3.5-lightning-30b-a3b",
  "messages": [
    { "role": "system", "content": "Tu es un agent de code. [...]" },
    { "role": "user", "content": "Que fait la fonction subtotal du fichier src/panier.js ?" }
  ],
  "tools": [ { "type": "function", "function": { "name": "read", "...": "..." } } ]
}Quand le modèle veut un outil, il ne répond pas par du texte mais par un appel d'outil, et le finish_reason vaut tool_calls :
{
  "message": {
    "role": "assistant",
    "content": null,
    "tool_calls": [
      {
        "id": "call_9",
        "type": "function",
        "function": { "name": "read", "arguments": "{\"path\": \"src/panier.js\"}" }
      }
    ]
  },
  "finish_reason": "tool_calls"
}L'agent lit alors le fichier, puis renvoie toute la conversation, augmentée de deux messages : l'appel du modèle, et un message tool qui porte le résultat (avec le même id). Au tour suivant, le modèle a le contenu du fichier sous les yeux et peut répondre : finish_reason vaut stop, la boucle s'arrête.
Trois API pour la même chose
Vous croiserez trois formats. Ils disent tous la même chose (des messages, des outils, des appels d'outils), avec des noms différents :
| OpenAI Chat Completions | Anthropic Messages | OpenAI Responses | |
|---|---|---|---|
| Adresse | POST /v1/chat/completions | POST /v1/messages | POST /v1/responses |
| Utilisée par | OpenCode, pi, la plupart des serveurs | Claude Code | Codex |
| Consignes de l'agent | un message role: "system" | un champ system à part | un champ instructions |
| Outil décrit par | parameters | input_schema | parameters |
| Appel d'outil rendu | tool_calls dans le message | un bloc tool_use | un élément function_call |
| Résultat renvoyé | un message role: "tool" | un bloc tool_result | un élément function_call_output |
| Clé envoyée dans | Authorization: Bearer | x-api-key | Authorization: Bearer |
Documentation officielle : Chat Completions, Messages, Responses.
Voici la même demande (« lis src/panier.js », avec un outil read) et ce que rendent réellement les trois API, en ne gardant que l'appel d'outil :
// Chat Completions
"tool_calls": [{ "id": "call_9", "type": "function",
  "function": { "name": "read", "arguments": "{\"path\": \"src/panier.js\"}" } }]

// Anthropic Messages
"content": [{ "type": "tool_use", "id": "call_11", "name": "read",
  "input": { "path": "src/panier.js" } }]

// OpenAI Responses
"output": [{ "type": "function_call", "call_id": "call_12", "name": "read",
"arguments": "{\"path\": \"src/panier.js\"}" }]Que se passe-t-il derrière ? Le proxy de la classe
Dans cette série, vos agents passent par llm-proxy, le proxy de votre enseignant. Il met plusieurs fournisseurs derrière une seule adresse, et laisse chaque agent parler sa propre API :
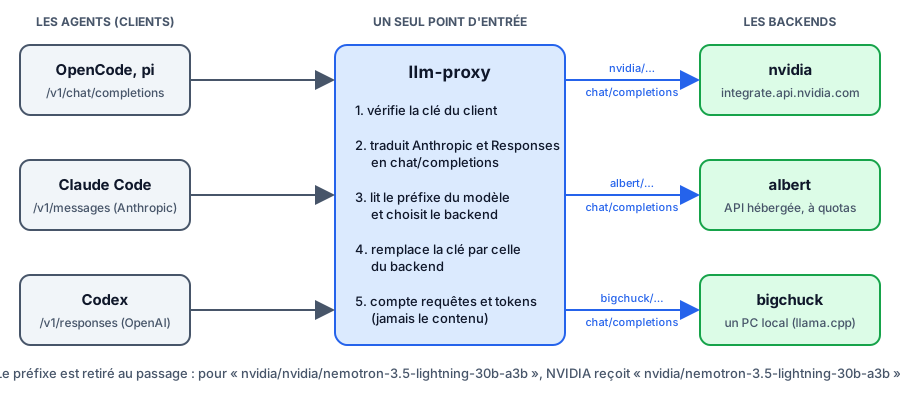
- Le préfixe du nom de modèle choisit le backend :
nvidia/nvidia/nemotron-3.5-lightning-30b-a3bpart chez NVIDIA, et le proxy retirenvidia/au passage. - Les requêtes Anthropic (
/v1/messages) et Responses (/v1/responses) sont traduites en Chat Completions : aucun backend n'a besoin de parler les trois. - La clé du fournisseur ne vit que dans le proxy : vous n'avez que la clé du proxy.
Nous l'avons vérifié en envoyant le même « Bonjour » par les trois API : le backend a reçu trois fois une requête /v1/chat/completions, avec le préfixe retiré ("model": "agent-demo" au lieu de demo/agent-demo).
Question :
- Codex parle l'API Responses. Le proxy de la classe la traduit vers des backends qui ne connaissent que Chat Completions. Avec OpenAI, l'API Responses peut garder la conversation côté serveur (
previous_response_id) ; le proxy, lui, répond400: « ce proxy ne conserve rien, renvoyer l'historique dansinput». Pourquoi est-ce cohérent avec ce que vous savez du modèle ?
Réponse
Le modèle n'a aucune mémoire : quelqu'un doit renvoyer tout l'historique à chaque tour. Soit c'est le serveur du fournisseur qui le garde et le recolle (OpenAI avec previous_response_id), soit c'est le client. Le proxy a fait le choix de ne rien stocker : c'est donc à l'agent de tout renvoyer, comme il le fait déjà avec Chat Completions.
À vous de jouer : faire tourner la boucle à la main
Pour vraiment comprendre, rien ne vaut de jouer soi-même le rôle de l'agent. Votre enseignant vous donne l'adresse du proxy, une clé et un nom de modèle. Ne les écrivez jamais en dur dans un fichier : mettez-les dans des variables d'environnement, le temps de la session.
export LLM_PROXY_URL="https://adresse-donnee-par-l-enseignant"
export LLM_PROXY_API_KEY="votre-cle"Vérifiez d'abord que le proxy vous répond, en listant les modèles :
curl -s -H "Authorization: Bearer $LLM_PROXY_API_KEY" "$LLM_PROXY_URL/v1/models" | jq -r '.data[].id'Récupérez ensuite le petit projet du TP suivant, décompressez-le et placez-vous dans son dossier. Créez un fichier tour1.json (remplacez MODELE par le nom donné par votre enseignant) :
{
  "model": "MODELE",
  "messages": [
    { "role": "system", "content": "Tu es un agent de code. Pour lire un fichier du projet, appelle l'outil read." },
    { "role": "user", "content": "Que fait la fonction subtotal du fichier src/panier.js ?" }
  ],
  "tools": [
    {
      "type": "function",
      "function": {
        "name": "read",
        "description": "Lit un fichier du projet et renvoie son contenu",
        "parameters": {
          "type": "object",
          "properties": { "path": { "type": "string", "description": "Chemin du fichier" } },
          "required": ["path"]
        }
      }
    }
  ]
}Premier tour : envoyez-le au modèle.
curl -s "$LLM_PROXY_URL/v1/chat/completions" \
  -H "Authorization: Bearer $LLM_PROXY_API_KEY" \
  -H "Content-Type: application/json" \
-d @tour1.json | tee reponse1.json | jq '.choices[0]'Si tout va bien, le modèle ne répond pas à la question : il demande l'outil read. Vérifiez le chemin qu'il demande (arguments), puis jouez l'outil : c'est vous qui lisez le fichier et qui renvoyez son contenu. Cette commande ajoute à la conversation l'appel du modèle et un message tool avec le contenu de src/panier.js :
jq --slurpfile r reponse1.json --rawfile code src/panier.js \
  '.messages += [$r[0].choices[0].message,
     {"role": "tool", "tool_call_id": $r[0].choices[0].message.tool_calls[0].id, "content": $code}]' \
tour1.json > tour2.jsonDeuxième tour :
curl -s "$LLM_PROXY_URL/v1/chat/completions" \
  -H "Authorization: Bearer $LLM_PROXY_API_KEY" \
  -H "Content-Type: application/json" \
-d @tour2.json | jq '.choices[0].message.content, .choices[0].finish_reason, .usage'Questions :
- Quel est le
finish_reasonau premier tour ? Et au second ? - Comparez
usage.prompt_tokensentre les deux tours. Pourquoi a-t-il augmenté ? - Que se passerait-il si vous renvoyiez dans le message
toolle contenu d'un autre fichier que celui demandé ?
Réponse
- Premier tour :
tool_calls(le modèle attend le résultat d'un outil). Second tour :stop(il a répondu, la boucle est finie). - Au second tour, vous avez renvoyé toute la conversation plus le contenu de
src/panier.js: il y a beaucoup plus de texte en entrée, donc plus de tokens. - Le modèle n'a aucun moyen de le vérifier : il croit ce que l'agent lui dit et répondra à partir de ce faux contenu. Le modèle fait entièrement confiance à ce qui entre dans son contexte. Gardez cette idée pour les injections de prompt.
Point de contrôle
Vous avez fait tourner deux tours de boucle à la main : un appel d'outil (finish_reason à tool_calls), le résultat renvoyé dans un message tool, puis une réponse finale (finish_reason à stop) qui explique ce que fait subtotal. Un agent ne fait rien d'autre, simplement beaucoup plus vite et des dizaines de fois de suite.
Pas de clé, ou le proxy ne répond pas ? Pas de panique : lisez la suite, les exemples ci-dessus montrent des réponses réelles.
Les tokens
Un token ?
Un modèle ne lit pas des caractères mais des tokens : des morceaux de mots. « Bonjour » peut être un seul token, « anticonstitutionnellement » plusieurs. En moyenne, comptez environ 4 caractères par token (un peu moins en français qu'en anglais, et beaucoup moins pour du code plein de symboles).
Tout se compte en tokens : la taille de la fenêtre de contexte, les limites de débit, et le prix. Et on distingue toujours deux sens :
- les tokens d'entrée (input, prompt) : tout ce qui est envoyé au modèle ;
- les tokens de sortie (output, completion) : ce qu'il produit. Ils sont plusieurs fois plus chers.
Ce qu'un agent envoie vraiment
Nous avons mesuré ce qu'OpenCode 2.2.6 envoie au modèle quand on lui demande, sur le petit projet du TP suivant, « Ajoute des codes promo au panier. Commence par lire le code et propose-moi un plan. » (il lit un fichier, lance les tests, puis répond) :

Ce qui frappe :
- votre demande pèse moins de 1 % du texte envoyé ; l'essentiel, ce sont les consignes de l'agent et la description de ses outils ;
- tout est renvoyé à chaque tour : trois tours, c'est trois fois les 23 000 caractères de départ ;
- le contexte ne fait que grossir au fil de la session.
Que se passe-t-il derrière ? Le cache
Comme le début du contexte ne change pas d'un tour à l'autre, beaucoup de fournisseurs le gardent en cache et facturent ces tokens « déjà vus » bien moins cher. C'est pour ça que les agents évitent de modifier le début de la conversation. llm-proxy, lui, ne cache rien, mais il veille à ne pas casser le cache des serveurs qui sont derrière (il le mesure : colonne Cache de son tableau de bord).
Un contexte limité : la compaction
Le contexte grossit à chaque tour, mais la fenêtre, elle, ne grandit pas. Que fait l'agent quand elle est presque pleine ? Il ne peut pas simplement couper le début : il perdrait la demande de départ, et le modèle ne saurait plus ce qu'il est en train de faire.
Il compacte. Quand le contexte approche de la limite (le seuil dépend de l'agent), il fait une pause dans la tâche et envoie au modèle une demande spéciale : « Résume cette conversation : le but, ce qui a été fait, les décisions prises, les fichiers modifiés, ce qu'il reste à faire. » Puis il repart de ce résumé : l'historique complet est remplacé par le résumé et les tout derniers échanges. Les consignes de l'agent, la définition des outils et AGENTS.md, eux, sont toujours renvoyés tels quels.

Un exemple
Reprenons la tâche du TP suivant : vous demandez à l'agent d'ajouter la livraison et les codes promo au panier de la Boutique BTS. En route, vous lui précisez deux choses : « les prix sont en centimes, pas en euros », puis « le seuil de 50 € de la livraison offerte se calcule après la remise ». L'agent lit src/panier.js, src/catalogue.js, la page, lance les tests plusieurs fois, se trompe sur un arrondi, corrige… Treize tours plus tard, la fenêtre est presque pleine.
Voici le genre de résumé qu'il produit pour repartir :
Objectif : livraison (4,90 €, offerte dès 50 €) et codes promo
           (BTS10 : -10 % du sous-total, LIVRAISON : livraison offerte).
Fait : calcul de la remise et de la livraison dans src/panier.js ;
       5 tests ajoutés dans test/panier.test.js, tous verts.
Décisions : les montants restent en centimes (entiers).
Reste à faire : champ « Code promo » sur la page, message pour un code inconnu.Comparez avec ce que vous aviez dit : « les prix sont en centimes » a survécu, mais « le seuil se calcule après la remise » a disparu. Si l'agent retouche le calcul pour brancher la page, rien ne l'empêche de comparer le seuil au sous-total avant remise : un panier de 50,60 € avec BTS10 (45,54 € après remise) aurait alors la livraison offerte, à tort. Et le contenu exact des fichiers lus n'est plus dans le contexte : s'il en a besoin, il devra les relire (de nouveaux tokens).
Questions :
- Pourquoi l'agent ne se contente-t-il pas de supprimer les premiers messages de l'historique ?
- Comment auriez-vous pu éviter de perdre la règle du seuil de livraison ?
Réponse
- Les premiers messages contiennent la demande de départ : sans elle, le modèle ne saurait plus quel est le but. Un résumé garde l'essentiel de tout l'historique, début compris, en beaucoup moins de tokens.
- En l'écrivant ailleurs que dans la conversation : dans
AGENTS.md(renvoyé à chaque tour, il survit à toutes les compactions) si c'est une règle du projet, ou dans un test (panier de 50,60 € avecBTS10: livraison à 4,90 €) qui échouera si l'agent l'oublie. Une règle qui compte ne doit pas vivre seulement dans le fil de la discussion.
Un petit calcul : avec une fenêtre de 32 768 tokens, une compaction déclenchée à 80 % et un contexte de départ de 5 800 tokens, combien de fichiers de 2 000 tokens l'agent peut-il lire avant de devoir compacter ?
Réponse
80 % de 32 768, c'est environ 26 200 tokens. Il reste 26 200 - 5 800 = 20 400 tokens, soit 10 fichiers de 2 000 tokens (sans compter les sorties de commandes et les réponses du modèle, qui consomment aussi de la place). Sur un vrai projet, c'est vite atteint : d'où l'intérêt des modèles à grande fenêtre, et surtout de sessions courtes.
Les bons réflexes
- Une tâche, une session : quand une tâche est terminée et commitée, ouvrez une nouvelle session plutôt que d'enchaîner dans la même.
- Ce qui doit durer va dans
AGENTS.mdou dans les tests, pas dans le fil de la conversation. - La plupart des agents vous laissent aussi compacter à la main, au bon moment (par exemple la commande
/compactde Claude Code, ou celle du chat de llm-proxy), et vous montrent le remplissage de la fenêtre : surveillez-le.
Les risques de la compaction (des détails qui disparaissent sans prévenir) sont traités dans le TP sur les limites.
Ce que ça coûte
Les fournisseurs payants facturent au million de tokens. Quelques prix relevés le 8 novembre 2026 sur la page des modèles d'OpenCode, en dollars par million de tokens :
| Modèle | Entrée | Sortie | Entrée en cache |
|---|---|---|---|
| DeepSeek V4.1 Flash | 0,30 $ | 1,20 $ | 0,006 $ |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | 0,20 $ |
| GPT 5.5 | 5,00 $ | 30,00 $ | 0,50 $ |
C'est à vous de jouer ! Calculez, sans le cache :
- le prix des trois tours mesurés plus haut (18 500 tokens d'entrée, environ 300 de sortie) avec Claude Sonnet 5.5 ;
- le prix d'une après-midi de travail avec un agent : 150 tours de boucle, avec un contexte moyen de 40 000 tokens en entrée et 500 tokens de sortie par tour, avec Claude Sonnet 5.5 puis avec DeepSeek V4.1 Flash ;
- la même après-midi pour une classe de 30 étudiants.
Réponse
- Entrée : 18 500 × 2 / 1 000 000 = 0,037 $. Sortie : 300 × 10 / 1 000 000 = 0,003 $. Environ 0,04 $ : quelques centimes, pour une seule petite demande.
- Entrée : 150 × 40 000 = 6 000 000 tokens ; sortie : 150 × 500 = 75 000 tokens.
- Claude Sonnet 5.5 : 6 × 2 + 0,075 × 10 = 12 + 0,75 = 12,75 $ ;
- DeepSeek V4.1 Flash : 6 × 0,30 + 0,075 × 1,20 = 1,80 + 0,09 = 1,89 $.
- Multipliez par 30 : environ 380 $ avec Claude Sonnet 5.5, 57 $ avec DeepSeek V4.1 Flash. Pour une seule séance.
Le cache fait baisser ces chiffres (une bonne partie de l'entrée est relue), mais l'ordre de grandeur reste : un agent consomme énormément de tokens d'entrée, bien plus qu'un chat. C'est aussi pour ça que les offres « gratuites » ont des quotas, et que le proxy de la classe compte ce que chacun consomme.
Pour résumer
Questions de synthèse, à faire sans relire le TP :
- Qui exécute la commande
npm testquand un agent « lance les tests » : le modèle ou l'agent ? Sur quelle machine ? - Pourquoi un agent consomme-t-il beaucoup plus de tokens qu'un chat pour la même question ?
- Quel champ de la réponse Chat Completions vous dit que le modèle veut un outil ?
- Que contient le fichier
AGENTS.md, et quand est-il lu ?
Réponse
- L'agent, sur votre machine (ou dans votre dev-box). Le modèle, lui, a seulement demandé l'appel ; il ne voit que le résultat que l'agent lui renvoie.
- Parce qu'il renvoie à chaque tour tout le contexte : ses consignes, la description de ses outils, l'historique, le contenu des fichiers lus et la sortie des commandes. Et une tâche demande souvent beaucoup de tours.
finish_reasonvauttool_calls, et le message contient un tableautool_calls(nom de l'outil et arguments en JSON).- Les règles du projet que le modèle ne peut pas deviner (commandes, conventions, interdits). L'agent le recopie au début du contexte, à chaque tour.
Conclusion
Dans ce TP, vous avez vu que :
- un agent de code est un modèle de langage placé dans une boucle : il lit le contexte, décide, demande un outil, l'agent l'exécute et lui renvoie le résultat ;
- le modèle n'exécute rien et ne retient rien : c'est l'agent qui agit sur votre machine et qui renvoie tout l'historique à chaque tour ;
- un agent, c'est un modèle, un contexte limité par sa fenêtre, des outils, des permissions et des fichiers d'instructions comme
AGENTS.md; - quand la fenêtre se remplit, l'agent compacte : il remplace l'historique par un résumé, et ce qui n'y figure pas est perdu ;
- trois API se partagent le terrain (Chat Completions, Anthropic Messages, Responses) et un proxy comme llm-proxy peut les traduire ;
- tout se paie en tokens, et un agent en consomme beaucoup.
Place à la pratique ! Dans le TP suivant, vous installez OpenCode, vous le branchez sur un modèle gratuit et vous lui faites ajouter une fonctionnalité à un vrai petit projet, en gardant la main à chaque étape.
👋 Si vous avez des questions, n'hésitez pas.